GENSHI AI、日本語医療QAデータ100万件超を公開 非商用研究向けに無償提供
掲載日:


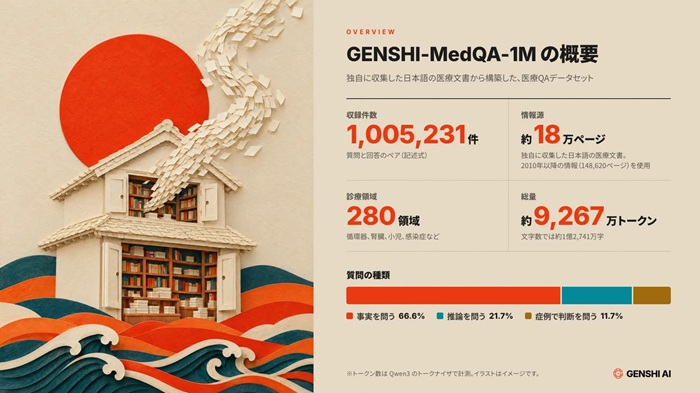
医療AI(人工知能)開発のGENSHI AI(ゲンシエーアイ、東京・千代田区)は10月15日、日本語の医療分野の質問と回答を100万件超収録したデータセット「GENSHI-MedQA-1M(ゲンシ・メドキューエー・ワンエム)」を公開したと発表した。医療機関や大学・研究機関などを対象に、非商用の研究目的限定で無償提供する。2026年10月12日時点の同社調査では、公開されている日本語のテキスト医療QAデータセットとして最大規模という。
同社は、独自に収集した日本語の医療文書17万9479ページのうち、2010年以降の情報14万8620ページを基に、生成AIで100万5231組の質問と回答を作成した。日本の保険適用や医薬品の承認状況、診療慣行などを反映した大規模言語モデル(LLM)の研究に役立てる。
質問と回答は記述式で、循環器や腎臓、小児、感染症など280の診療領域を収録する。質問の内訳は、事実を問うものが66.6%、推論を問うものが21.7%、症例を示して判断を問うものが11.7%という。
利用は申請制で、AIモデルやデータセットの公開サイト「Hugging Face(ハギングフェイス)」の専用ページから氏名、所属、利用目的などを登録する。その後、ゲンシエーアイが申請内容を確認し、承認すれば利用できる。営利目的のモデル学習を含む商用利用はできない。
データは生成AIで作成しており、人手による全件の検証は行っていない。同社は、診断や治療の判断、患者への助言には使用しないよう求めている。
ゲンシエーアイによると、これまで公開された日本語の医療QAデータセットは、医師国家試験の過去問題や英語データの機械翻訳を基にしたものが中心だったという。同社では翻訳だけでは日本の診療に固有の知識を十分に補えないとみて、日本語の医療文書を基に学習用データを整備した。
今後は研究者からの意見を基に誤りの修正や収録内容の見直しを進める。自社の医療機関向け閉域LLM基盤「MedLocal(メドローカル)」などの開発にも活用する。