NTTデータ、治験候補患者抽出を効率化 近大病院で肺がん確認対象97%超削減、生成AIも活用へ
掲載日:


NTTデータは11月13日、電子カルテなどの医療リアルワールドデータ(RWD)を活用して治験候補患者を抽出する「治験候補者 選定支援サービス」の技術検証で、確認対象の候補患者数を97%以上削減したと発表した。近畿大学病院と実施した。医師や治験コーディネーター(CRC)がカルテを目視して候補患者を探す作業を効率化し、治験期間の短縮につなげる。
新薬の治験では、適格・除外基準を満たす患者を医師やCRCが診療情報から探し出す必要がある。NTTデータによると、治験候補患者の選定は担当者の経験や目視確認に依存する部分が大きく、患者の見落としや作業時間のばらつきもあるという。
また、治験の実施までの時間も課題となっている。治験依頼から最初の患者を組み入れる「FPI(ファースト・ペイシェント・イン)」までの日数は中央値で114日、FPIから最後の患者を組み入れる「LPI(ラスト・ペイシェント・イン)」まで124日もかかっているという。
同社は、こうした課題解決に向け、治験候補患者の選定支援サービス「治験候補者 選定支援サービス」を2026年7月に開始した。
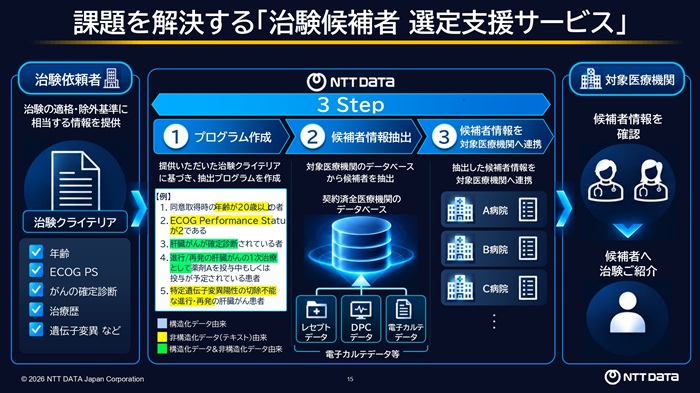
サービスは、まずNTTデータが製薬会社から適格・除外基準を受け取り、レセプト(診療報酬明細書)やDPC(診断群分類)などの構造化データ、電子カルテの診療記録などの非構造化データのうち、どのデータで条件を判定するかを整理する。基準は一般的な治験で30~40項目程度という。
次に、データベース言語「SQL」やプログラミング言語「Python(パイソン)」などを使った抽出プログラムを作成し、契約する医療機関のレセプト、DPC、電子カルテのデータから候補患者を抽出する。
候補者が見つかった場合は、患者のIDを医療機関に提供。医師などが内容を確認して候補者に治験の参加を案内する。
サービスは、レセプトやDPCなどの構造化データに加え、電子カルテの診療記録や経過記録、医師の所見といった自由記載テキストの非構造化データも解析できる点が特長だ。
電子カルテなどから、病歴や検査結果、治療経過といった情報を抽出し、治験の適格基準の判定に利用する。電子カルテのデータは、医療情報の共通規格「MML」で受け取り、管理・検索するため、ベンダーを問わず利用できる。
大学病院や地域の中核病院を中心に11の医療機関と提携しており、すでに製薬会社3社から申し込みがあった。医療機関は600床以上の大規模病院が多いという。治験実施施設だけではなく、周辺の医療機関やかかりつけのクリニックから候補患者を見つけ、治験実施施設に紹介する仕組みにも取り組む。
NTTデータでは近畿大病院と、同院で過去に実施した肺がん領域の医師主導治験2試験を対象に、サービスの技術検証を実施した。電子カルテ、レセプト、DPCなどのデータを使用し、約3000人の患者を母集団として候補患者を抽出した。
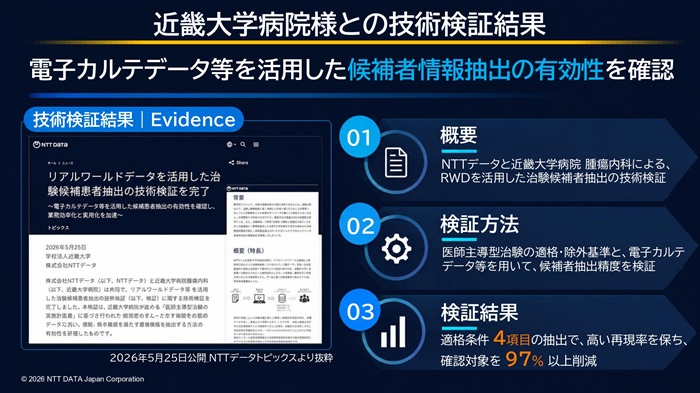
検証では、治験の条件のうち、「がんの組織型」「遺伝子変異情報」「がんのステージ」「ECOG Performance Status(PS、患者の日常生活の活動度を示す指標)」の4項目で候補患者を絞り込んだ。その結果、1つの試験では医師などが詳しく確認する対象を75人まで絞り込み97.4%削減、もう1つの試験では18人まで絞り込み99.4%削減したという。
込山哲弘・第二インダストリ事業本部製薬事業部課長は、11日の記者説明会で「今回の検証では、候補者確認の省力化・迅速化と、見落としの抑制につながる可能性を示せた」と説明した。
NTTデータは、近畿大病院、中外製薬、NTTと、RWDと生成AI(人工知能)を組み合わせた治験候補患者抽出の共同研究も6月から開始した。
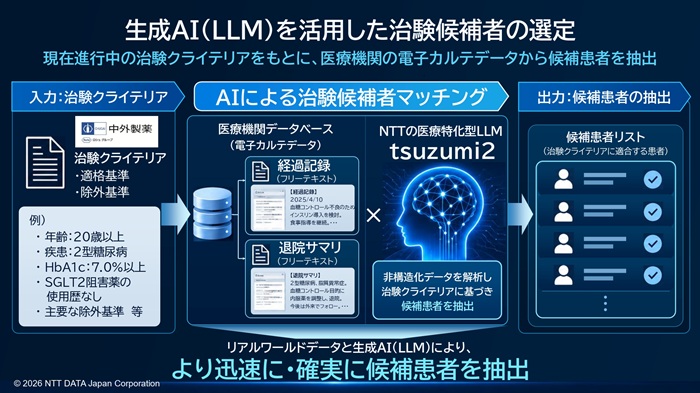
中外製薬から提供された治験の適格・除外基準と、電子カルテの経過記録や退院サマリーなどの非構造化データを組み合わせ、NTTが開発したLLM(大規模言語モデル)「tsuzumi(つづみ) 2」で候補患者を抽出する。
「tsuzumi 2」は医療特化モデル「医療コーパス版」を使用する。NTTデータでは共同研究に先立ち、NTT東日本関東病院(東京・品川区)で候補患者抽出の初期検証を実施し、一定の有用性を確かめた。ハルシネーション(幻覚)の発生や程度は、今回の研究で検証する。
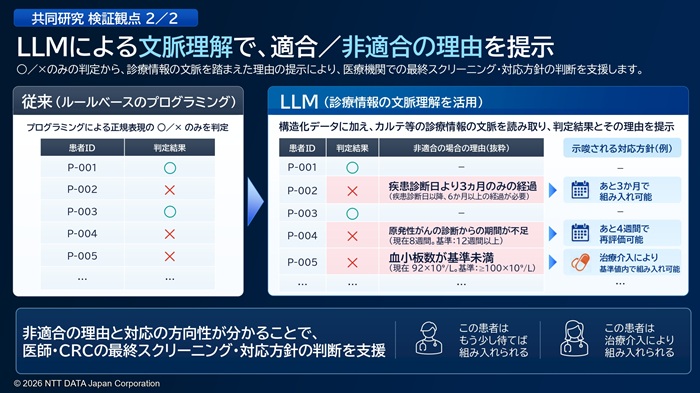
研究では、LLMが診療情報の文脈を読み取り、患者を「適合」と「非適合」にふるい分ける。「非適合」と判断した場合は、その理由も提示する。
例えば、治験参加に診断から6カ月以上の経過が必要なケースで、現在3カ月しか経過していないと、「非適合」とするだけでなく「あと3カ月で組み入れ可能」といった情報を示す。
血小板数などの検査値が基準を満たしていない場合には、その数値を基に「非適合」と判断した理由も提示する。理由を示すことで、医師やCRCが最終的な対応方針などを判断しやすくする。
込山課長は「従来のプログラムでは、条件に適合するか否かという判定が中心だったが、LLMによる文脈理解を活用すれば、不適合と判断した理由や、今後条件を満たす可能性も示せると考えている」と説明した。
RWDを活用した抽出が医師やCRCによる従来のカルテ確認と比べて、どの程度作業時間を減らせるかも確かめる。込山課長は「治験期間を1カ月以上短縮することを目指したい」と述べた。「SQL」や「Python」を使った手法と候補患者の抽出精度や作業時間の比較・評価も行う。
研究結果は2027年2~3月ごろにまとめる。NTTデータでは、AIの活用で治験候補患者の選定を効率化し、製薬会社の新薬開発期間の短縮を支援する。